搜索

笃行实干谋创新,
聚力攻关结硕果。
我院科研团队立足学科前沿,
坚持基础研究与应用创新协同推进,
激发学术活力,
成果相继涌现。
1、智慧纳米机器人与纳米系统国际研究院Microsystems & Nanoengineering:Magnetically Actuated Microrobotic System for Sequential Treatment of Biofilm
近日,我院智慧纳米机器人与纳米系统国际研究院梅永丰教授、宋恩名教授团队在工程技术领域一区Top期刊《Microsystems & Nanoengineering》发表题为《Active devices and systems for closed-loop neuromodulation》的综述论文。该综述围绕有源器件在闭环神经调控中的功能作用,梳理了神经信号耦合与放大机制,以及电、光、机械、磁、热等不同物理模态下器件的工作原理和性能特点;并总结了多模态神经接口的系统集成策略、代表性应用及临床转化前景。
在器件层面,首先归纳用于神经调控的主要有源器件类型。不同器件可在供能模块支持下,将电、光、声/机械、磁和热等外部能量转换为可控的神经调控信号,通过影响神经元兴奋性实现神经活动调节。从离子-电子信号耦合角度,对场效应耦合、界面离子积累、体相离子渗透及电化学反应等机制来比较,阐明不同器件在响应速度、灵敏度和生物电子应用方面的特点与权衡,为按需选择调控模态和开展多模态集成提供清晰的器件基础。
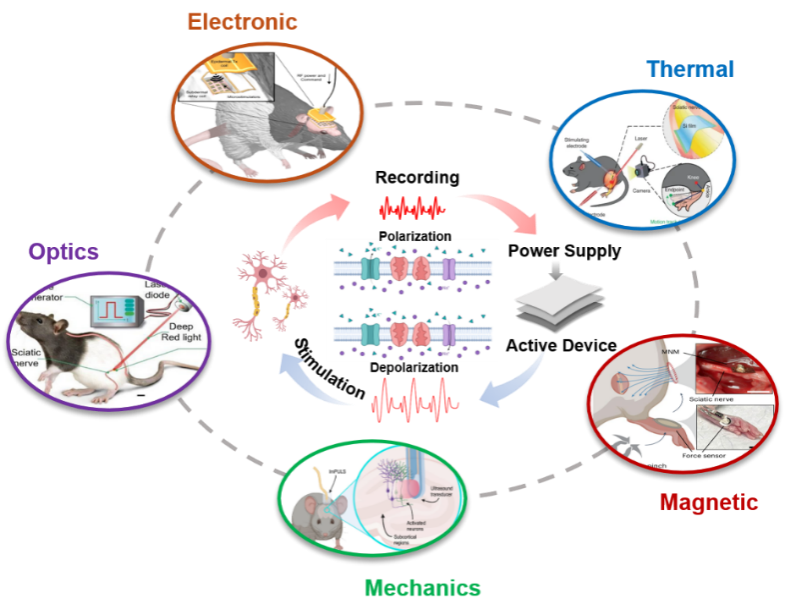
图1:不同类型的有源神经调控器件与系统
在系统层面,总结有源神经调控系统在柔性集成、微型化、无线供能和体内验证等方面的代表性进展。通过将神经记录、信号处理、精准刺激和反馈控制等功能集成于同一平台,相关系统可实现更稳定、更高保真的神经活动监测与调节,已在外周神经刺激、神经再生、运动功能恢复和感觉反馈等场景展现出应用潜力。现有系统仍面临长期稳定性、生物相容性、刺激选择性及自适应控制能力等挑战。未来,随着有源半导体器件、多模态传感、片上信号处理和智能算法融合,闭环神经调控有望向更加自主、精准且适于长期临床应用的方向发展。
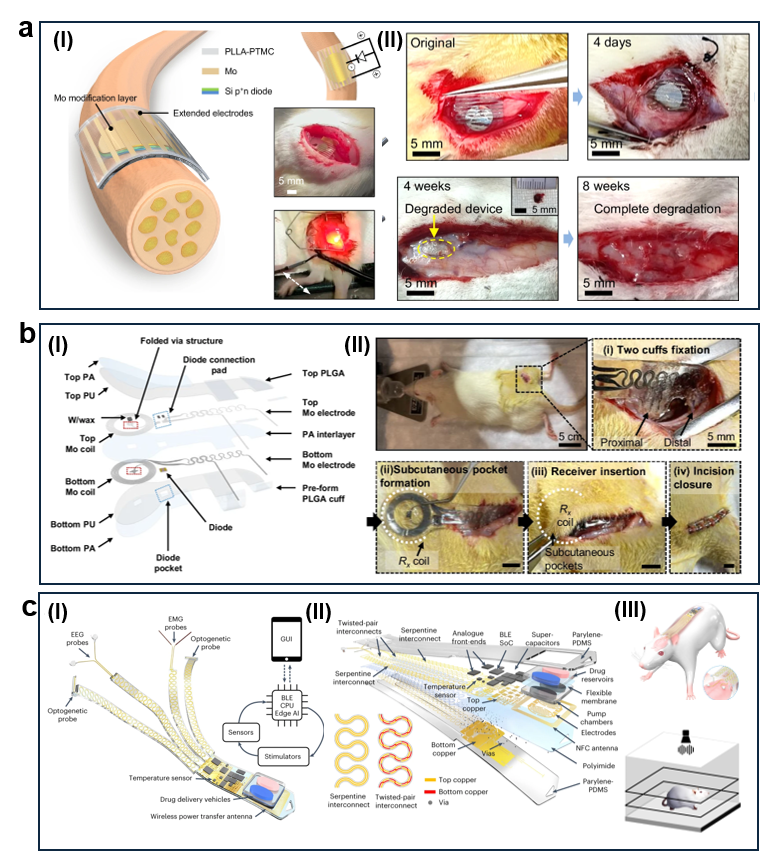
图2:面向闭环调控的代表性有源神经调控平台及其应用
复旦大学博士后王婧菲、薛惠泽和黎家豪博士为共同第一作者,梅永丰教授、宋恩名教授为共同通讯作者,得到科技部科技创新2030重大项目、国家自然科学基金等项目的资助和支持。
文章信息:
Jingfei Wang#, Huize Xue#, Jiahao Li#, Yihong Li, Rui Li, Yongfeng Mei* & Enming Song*, Active devices and systems for closed-loop neuromodulation, Microsystems & Nanoengineering, 2026, 12, 253.
原文链接:https://doi.org/10.1038/s41378-026-01357-3
2.智能机器人研究院 IEEE T-RO:仿生可重构灵巧手——“掌形重构”驱动手内操作新范式
近日,智能机器人研究院甘中学教授团队在机器人灵巧手与手内操作领域取得重要进展,相关成果以 “G-raph Hand: A Reconfigurable Anthropomorphic Hand With Hybrid Control and Lightweight Closure-Guided In-Hand Manipulation” 为题发表于机器人顶刊《IEEE Transactions on Robotics》。
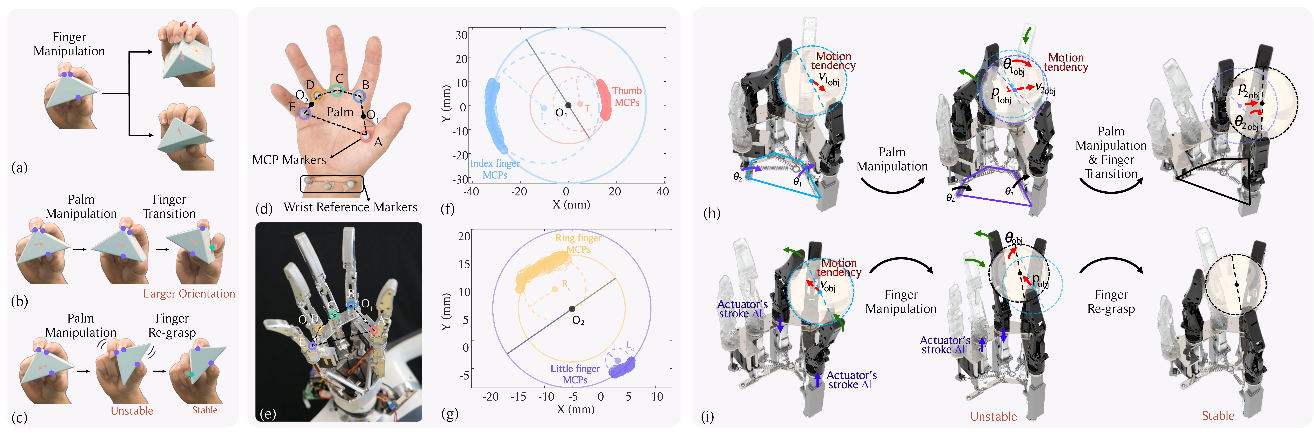
传统机器人灵巧手通常通过增加手指自由度提升操作能力,但也带来执行器数量增加、结构集成和控制复杂度上升等问题。针对这一挑战,研究团队从人类手内操作中的掌—指协同机制出发,发现拇指—食指与无名指—小指两组掌指关节具有明显的协同特征,表明手掌构型变化本身即可为物体手内运动提供重要驱动。基于这一规律,团队设计具有双输入五连杆可重构手掌的拟人机器人手 G-raph (光华Reconfigurable AnthropomorPHic) Hand,并结合中心弹簧欠驱动系统,使手指能够随掌形及物体接触状态自适应调整方向,在较少主动自由度下兼顾操作空间与接触适应性。团队进一步融合位置控制与力反馈控制,并提出基于手—物系统闭合属性快速评估的轻量化手指步态规划方法,通过不同手指组合的切换与重新抓取实现稳定、连续的手内操作。实验表明,G-raph Hand 能够适应不规则、细长、薄片等不同物体的抓取,并完成其丰富且稳定的手内灵巧操作任务。该研究通过结构重构、欠驱动适应与轻量化控制规划的协同,为有限驱动条件下实现灵巧手内操作提供了新的设计思路。
智能机器人研究院博士后卢秋洁与2024级博士生刘畅为共同第一作者,青年研究员张壮为通讯作者。该工作得到国家自然科学基金青年、面上项目和上海市科技重大专项等资助。
原文链接:https://doi.org/10.1109/TRO.2026.3721782
3.光源与照明工程系ACS Energy Letters:实现有机热电单材料双极发电
传统热电器件通常需要同时集成 p 型和 n 型材料。然而,高性能且稳定的 n 型有机热电材料长期匮乏,成为制约柔性热电器件发展的关键瓶颈。 近日,我院左光正课题组与德国海德堡大学 Martijn Kemerink 团队合作发现,无需更换材料,仅通过调节掺杂程度,同一种聚合物-掺杂剂体系便可在 p 型与 n 型热电响应之间切换,甚至实现多次极性反转。相关成果以“Dual-Polarity Thermoelectric Generation from a Single Polymer-Dopant System”为题发表于《ACS Energy Letters》。
这项工作表明,掺杂浓度不仅影响导电性,还可以成为调控热电极性的重要设计维度。态密度填充、库仑能隙和多重占据共同构成了理解极性反转的统一物理框架。未来,通过局域掺杂、图案化或梯度掺杂,有望在同一种材料中直接“写入”p 型和 n 型区域,从而简化柔性热电器件的材料选择与制备流程,并为可重构热电器件、温度传感和低品位热能利用提供新的设计思路。
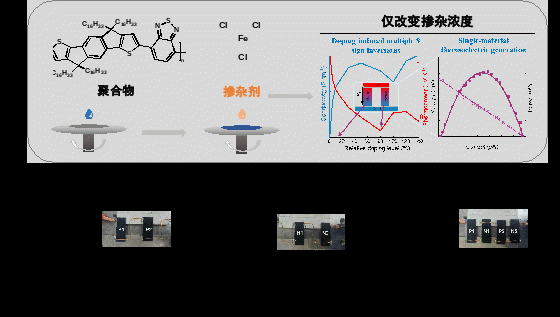
图. 基于单一聚合物-掺杂剂体系的双极热电发电器
本论文第一作者为我院硕士研究生李泽龙和海德堡大学的Scheunemann博士后,通讯作者为青年研究员左光正与德国海德堡大学 Kemerink 教授。该研究得到了我院郭睿倩研究员、张万路正高级工程师的支持,研究工作得到了上海市科委和欧盟 Marie Skłodowska-Curie 项目资助。
文章信息:Zelong Li#, Dorothea Scheunemann#, Yuqian Liu, Wanlu Zhang, Ruiqian Guo, Martijn Kemerink*, and Guangzheng Zuo*. Dual-Polarity Thermoelectric Generation from a Single Polymer-Dopant System. ACS Energy Letters, 11, 5915-5922, 2026.
原文链接:https://doi.org/10.1021/acsenergylett.6c01785
4. 可信具身智能研究院IEEE TPAMI:AR3D:基于下一对称视角预测的自回归图生3D框架
近日,我院可信具身智能研究院在三维内容生成领域取得新进展,相关成果以“Autoregressive Image to 3D Generation via Next Symmetric View Prediction”为题发表于人工智能领域权威期刊《IEEE Transactions on Pattern Analysis and Machine Intelligence》(IEEE TPAMI)。从单一视觉观测推断物体完整的三维结构,是三维视觉的重要基础问题,也为具身智能中的空间理解、物体建模与虚拟环境构建提供基础能力。但现有图生3D方法通常采用并行方式一次性生成多个视角,仅依赖单张输入图像时,距离输入视角较远的区域尤其是物体背面容易出现几何结构和纹理不一致。针对该问题,本研究提出自回归3D扩散模型AR3D,将图生3D中的多视角生成重新建模为“下一对称视角预测”问题。将预训练视频扩散模型改造为具有因果建模能力的自回归多视角生成器,使新视角能够基于输入图像和此前生成的视角逐步预测;利用环绕物体的多视角序列所具有的视角对称性,设计由近及远的下一对称视角预测策略,在每个自回归阶段同时生成一对对称视角,从而缩短自回归链路并缓解误差累积。基于生成的高一致性多视角图像,AR3D能进一步恢复具有完整几何结构和丰富纹理细节的三维模型。实验结果表明,AR3D在多个主流三维生成基准上均取得领先性能,能生成更加一致、真实的多视角图像,并在新视角合成和单视图三维重建任务中展现出较强的性能与泛化能力。
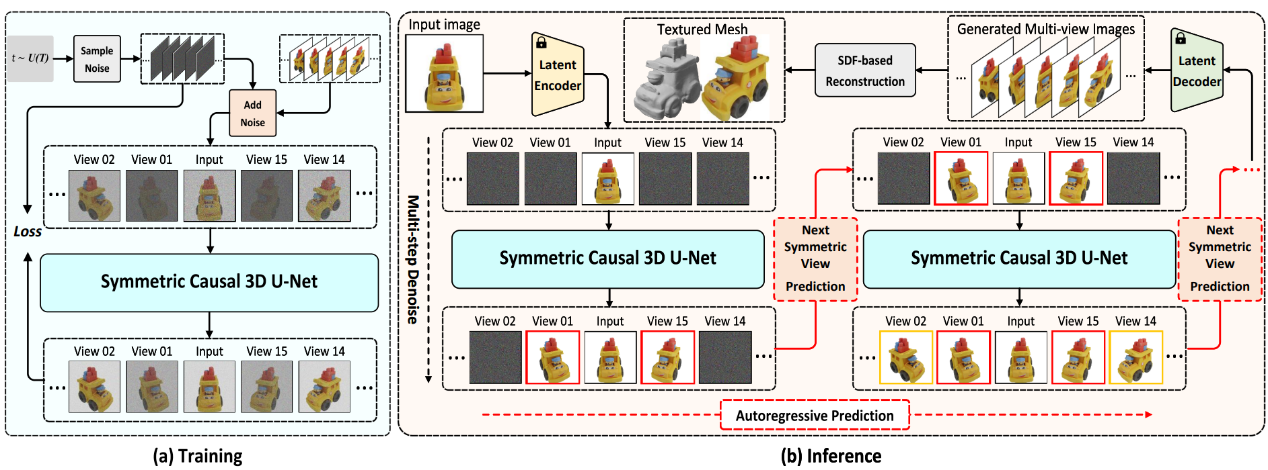
第一作者为2024级博士生杨海波,通讯作者为陈智能教授。研究得到上海市科委项目资助。
论文作者:杨海波,陈杨,潘滢炜,陈智能,姚霆,梅涛
论文链接:https://www.computer.org/csdl/journal/tp/5555/01/11663523/2jdtl39jnhK
5、智能机器人研究院IEEE TAFFC:面向心理健康与复杂医疗问询的多意图识别与规划框架
近日,认知与智能技术实验室(简称CIT Lab)张立华教授团队在大语言模型医疗智能体与心理健康辅助研究方面取得新进展。相关成果以“Toward Empathetic Care: An LLM-based Multi-Intention Recognition Framework for Mental Health and Complex Medical Queries”为题,被情感计算领域国际权威期刊IEEE Transactions on Affective Computing(TAFFC)录用。
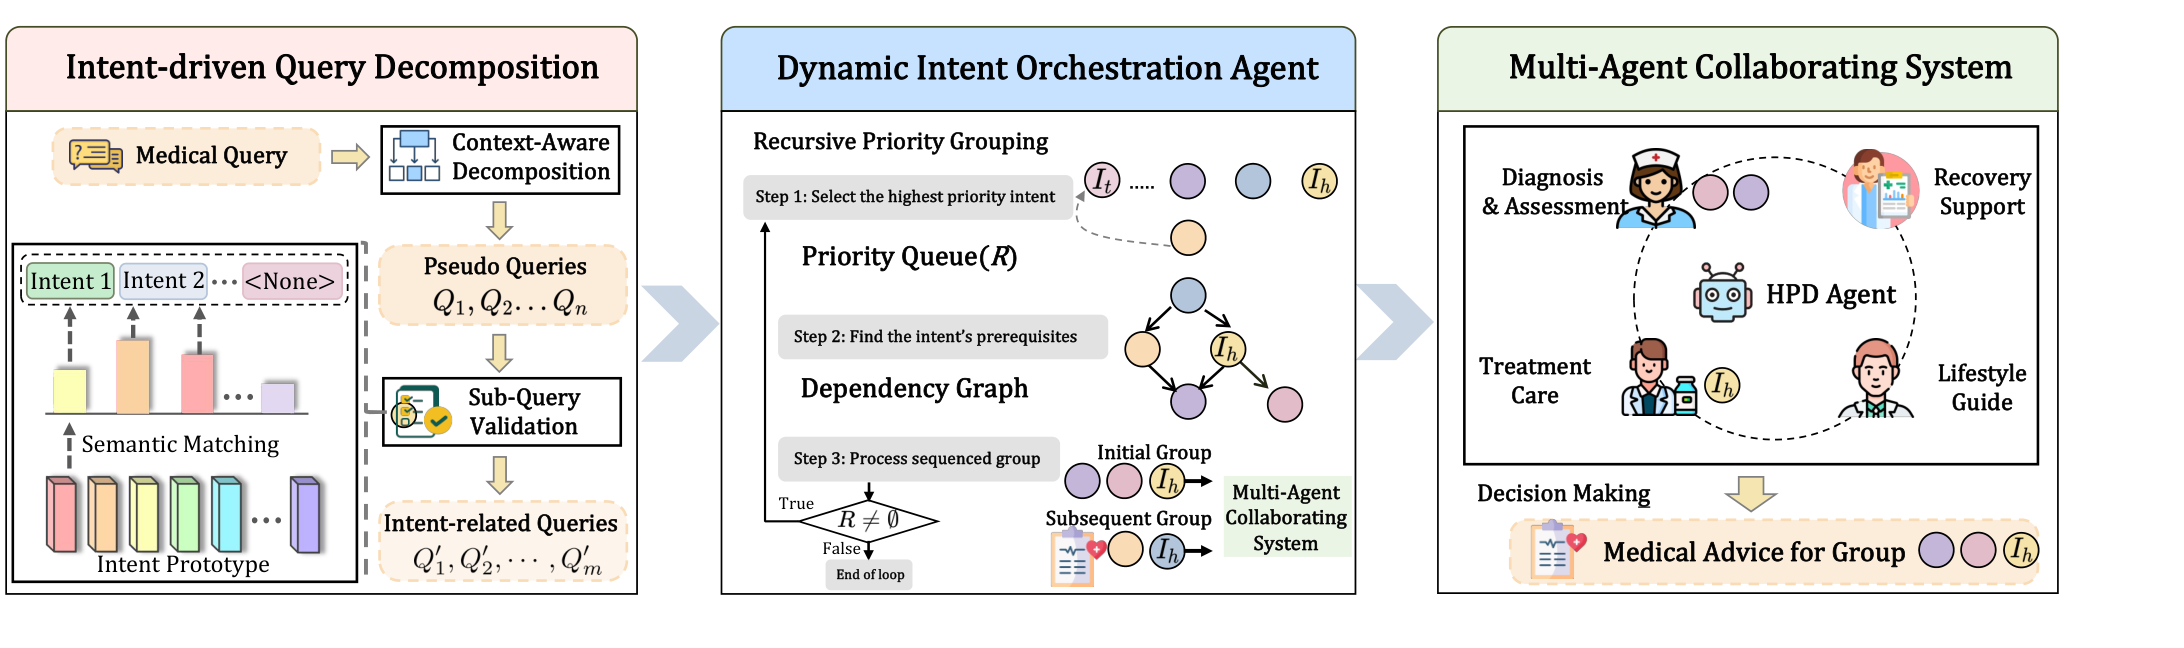
团队提出MIRA框架,将复杂患者描述转化为可识别、可排序和可协同处理的临床意图序列。MIRA构建由意图驱动查询分解、动态意图编排和多智能体协同决策组成的三阶段流程。框架首先通过两阶段意图识别模块,将冗长问询分解为临床子问题,并映射至覆盖诊断评估、治疗照护、康复支持和生活指导的14类医疗意图;动态意图编排(DIO)智能体结合临床依赖关系与安全优先级,对各项意图进行递归分组和顺序规划;分层渐进决策(HPD)智能体协调专科智能体逐步积累证据、检查一致性,并生成兼顾医学逻辑、情绪需求与风险控制的综合建议。
团队还基于真实去标识化医疗记录构建了包含2200个复杂样本的Mental Multi-Intention(MMI)数据集,并结合HuaTuo-26M等基准开展系统评测。实验结果表明,MIRA在意图理解、临床规划和响应质量方面均优于单智能体及现有多智能体方法,在MMI数据集上的三项评分分别达到4.89、4.75和4.66。医生盲评与统计显著性分析验证了该方法在复杂多意图问询中的优势;在心理支持与危机敏感场景中,MIRA也展现出更好的共情性、情绪适切性和治疗安全性。为构建更具共情能力、临床安全性和可信度的医疗人工智能助手提供了新的技术路径。
第一作者为杨鼎康助理教授(A),张立华教授为通讯作者。
原文链接:https://doi.org/10.1109/TAFFC.2026.3728254
6.智能机器人研究院IEEE Rob. Autom. Lett.:并联机器人尺寸参数优化新框架:兼顾高效评估与模型复用
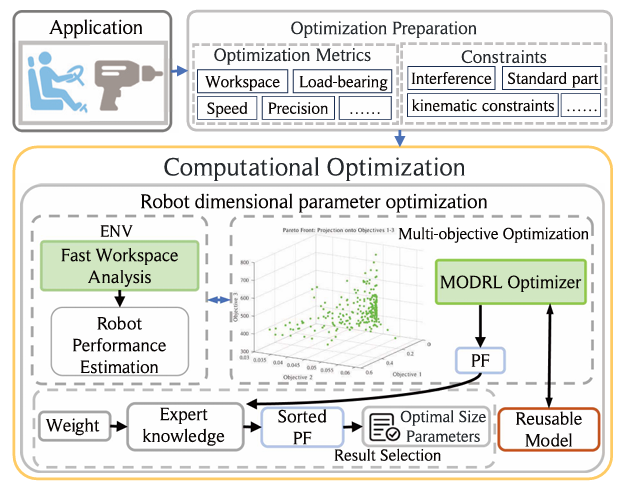
近日,智能机器人研究院甘中学教授团队在并联机器人尺寸参数优化领域取得重要进展,相关成果以 “Multi-Objective Deep Reinforcement Learning for Dimensional Optimization of Parallel Robots” 为题被机器人领域国际期刊《IEEE Robotics and Automation Letters》接收。
团队提出了一套面向并联机器人尺寸设计的双层优化框架。该框架在性能评估层采用两种边界确定方法,通过聚焦工作空间边界,提高评估效率与复杂边界分析精度;在尺寸优化层引入多目标深度强化学习,在复杂约束下搜索兼顾多项性能的 Pareto 最优方案,并支持优化经验在相关任务中的迁移复用。
团队以具有21个待优化尺寸参数的6-PUS并联机器人为对象,在驾驶模拟和电子装配两类任务中进行了验证。结果表明,该方法能够获得具有竞争力的多目标优化结果;将已有模型迁移至新任务并微调后,相比从头优化可减少19.6%的计算时间。可重构实物样机实验表明,可根据不同应用需求从同一Pareto解集中选择相应的尺寸方案,无需重新执行完整优化。该研究为需求变化条件下并联机器人的高效尺寸设计提供新的技术路径。
博士生张放为第一作者,博士后卢秋洁、甘中学教授为通讯作者。该工作得到国家自然科学基金项目和上海市科技重大专项资助。
原文链接:https://ieeexplore.ieee.org/stamp/stamp.jsp?tp=&arnumber=11592423
7、智能机器人研究院MIR:基于物理感知的人类动作风格理论与生成范式综述
近日,我院认知与智能技术实验室(简称CIT Lab)张立华教授团队在风格化动作生成研究方面取得新进展。相关成果以“A Survey of Human Motion Style Based on Physical Perception: Definitions, Causal Taxonomy, and Generative Paradigms”为题,被人工智能领域权威期刊Machine Intelligence Research(MIR)录用。
现有研究对动作风格的定义、分类及其与人体动作特征之间的关系缺乏统一认识,尚未形成系统的理论框架。针对上述问题,研究团队从物理感知和动作特征出发,系统梳理动作风格的理论基础,将其表征为三维感知空间中的连续分布与具有辨识度的离散动作锚点,并总结动作风格的判别机制与基本属性。
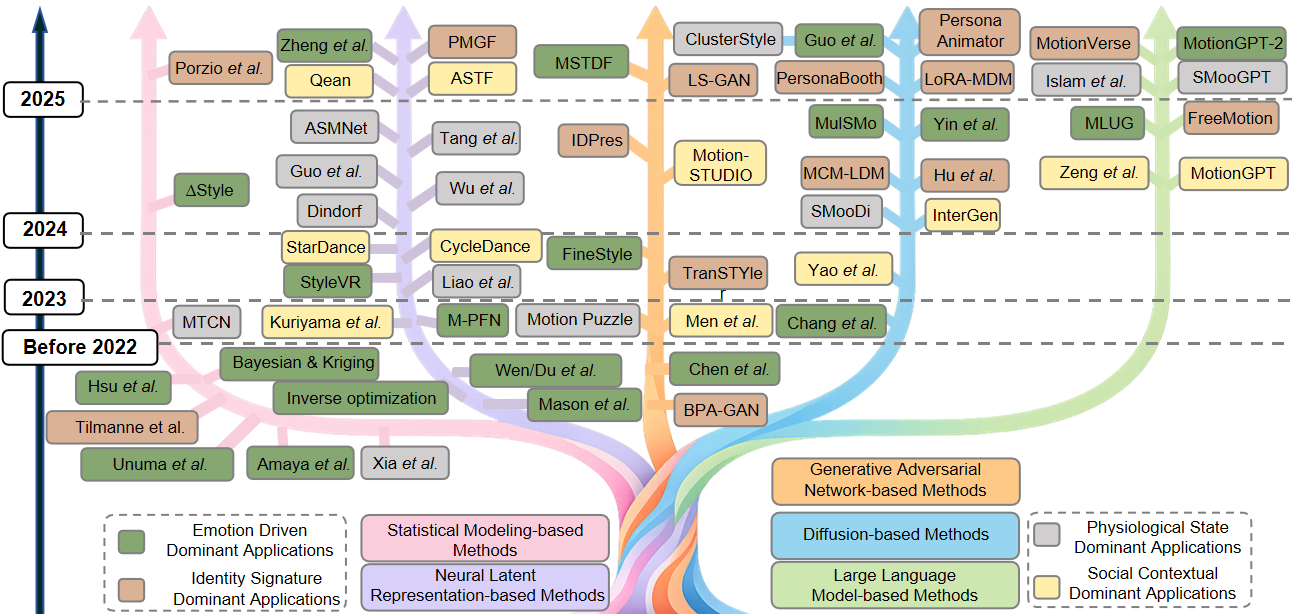
在此基础上,团队建立了以内在因果关系为基础的动作风格分类体系,将典型动作风格划分为情绪驱动、身份特征、生理状态和社会情境四大类别,并系统分析不同类别在视觉表现和动作特征层面的关键特征。同时,论文梳理了从统计建模、VAE、GAN到扩散模型和大语言模型的动作风格生成范式,总结相关数据集、评价指标、研究挑战与未来方向,为动作风格的可解释分析与生成建模提供了系统参考。
论文第一作者为2022级直博生钱子赟、杨鼎康助理教授(A)和魏金杰硕士,张立华教授、翟鹏青年研究员等为论文通讯作者。
原文链接:https://doi.org/10.36227/techrxiv.177160637.72794468/v1
8.可信具身智能研究院IEEE T MED ROBOT BIO:足底触觉反射控制的仿生踝足假肢研究
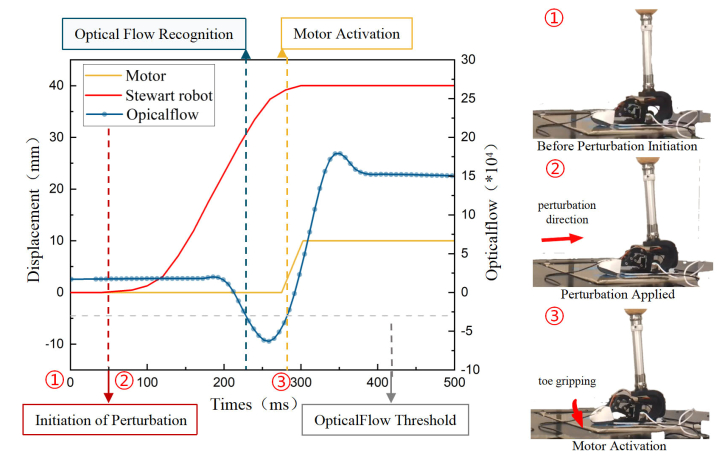
近日,我院可信具身智能研究院团队在《IEEE医学机器人与仿生学汇刊》-IEEE Transactions on Medical Robotics and Bionics发表最新成果,研发了一种具备足底触觉感知能力的仿生踝足假肢,成功模拟人体脚趾抓地反射机制,显著提升截肢者在复杂地形和扰动条件中的稳定性。现有假肢多侧重机械结构模仿,却忽视足底触觉反馈对动态平衡的关键作用。该假肢创新集成旋转/平移耦合仿生关节与足底多维力触觉传感模块,可实时监测足底剪切力变化。当检测到地面扰动时,假肢能在10毫秒内触发非自主性动作响应,系统整体响应延迟约93毫秒,与人体生物反射(Reflex Control)时间高度吻合。该研究不仅实现了“类人”足底皮肤触觉反馈,更验证了将生物力学机制嵌入假肢仿生系统的可行性,为截肢者重拾自然步态、应对突发路况提供可靠技术支撑,标志着智能假肢从“被动支撑”迈向“主动感知-响应”新阶段。
论文第一作者为许阳阳、马玉鑫,通讯作者为陈文明研究员。研究得到国家自然科学基金委/上海市科委项目资助。
论文作者:
许阳阳,马玉鑫、黄吉、罗虎、农庆钧、耿翔、马昕、陈文明
论文链接:https://ieeexplore.ieee.org/document/11606480/
9、智能机器人研究院IEEE TCSS:面向零方差梯度异常理解与鲁棒推理的连续性一致性感知策略优化
近日,我院认知与智能技术实验室(简称CIT Lab)张立华教授团队在大语言模型强化学习与多模态推理优化领域取得新进展,相关成果以“Consistency-Aware Policy Optimization for Zero-Variance Gradient Anomaly Understanding and Robust Reasoning”为题,被IEEE Transactions on Computational Social Systems录用。
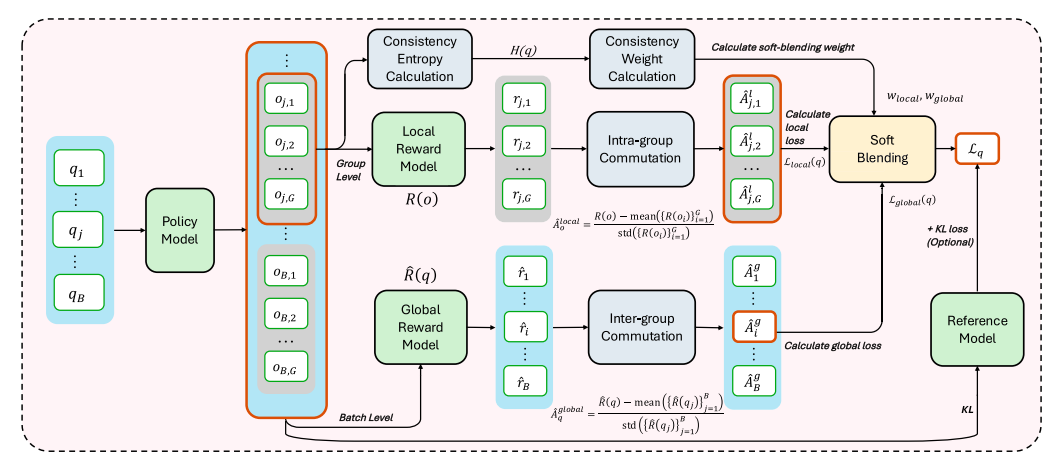
大语言模型的推理能力是实现可靠模型响应的重要基础,但现有群组相对策略优化(GRPO)在同一问题下多个响应获得相同奖励时,容易出现奖励方差为零、优势退化和梯度消失等问题,导致部分训练样本无法提供有效优化信号。针对该问题,本研究提出一致性感知策略优化方法(Consistency-Aware Policy Optimization,COPO),通过引入批次级全局优化机制,利用不同问题之间的奖励差异挖掘额外的学习信号,使原本无法产生有效组内优势的样本仍能参与模型优化;结合一致性熵设计局部与全局优化信号的软融合策略,根据模型响应的多样性动态调整两类优化信号的权重,从而提升训练稳定性和数据利用效率。实验在数学推理及多模态推理任务上开展验证,COPO整体优于GRPO、DAPO等基线方法,在MATH-500等任务上取得明显性能提升,并能够有效推广至视觉语言模型,在MathVision、MathVerse和LogicVista等多模态推理基准上保持良好的表现。进一步的消融实验表明,全局优化机制能够有效利用传统GRPO中因奖励一致而难以产生有效梯度的样本,软融合策略则能够进一步提升优化效果。COPO能够有效缓解零方差奖励导致的梯度消失问题,在充分利用训练数据的同时提升模型推理优化的稳定性与可靠性,为大语言模型及视觉语言模型的强化学习优化提供新的方法。
论文第一作者为2024级直博生韩菁杭,通讯作者为曹凯青年副研究员、杨鼎康助理教授(A)和张立华教授。
原文链接:https://ieeexplore.ieee.org/document/11663587
10、智能机器人研究院EMNLP 2026:基于Harness机制的复杂空间布局文生图框架
近日,我院认知与智能技术实验室(简称CIT Lab)张立华教授团队在复杂空间文生图研究方面取得新进展。相关成果以“SpatialGuard: Harness-Guided Verifiable Spatial Reasoning for Text-to-Image Generation”为题,被自然语言处理领域国际权威会议Empirical Methods in Natural Language Processing(EMNLP 2026)录用。
现有文生图模型在处理多物体、复杂方位关系、前后遮挡和镜头视角等空间要求时,容易出现物体遗漏、位置错乱和空间关系不一致等问题。针对上述挑战,研究团队提出SpatialGuard框架,在无需重新训练底层文生图模型的情况下,将自然语言提示转化为可编辑、可验证的三维结构化布局。
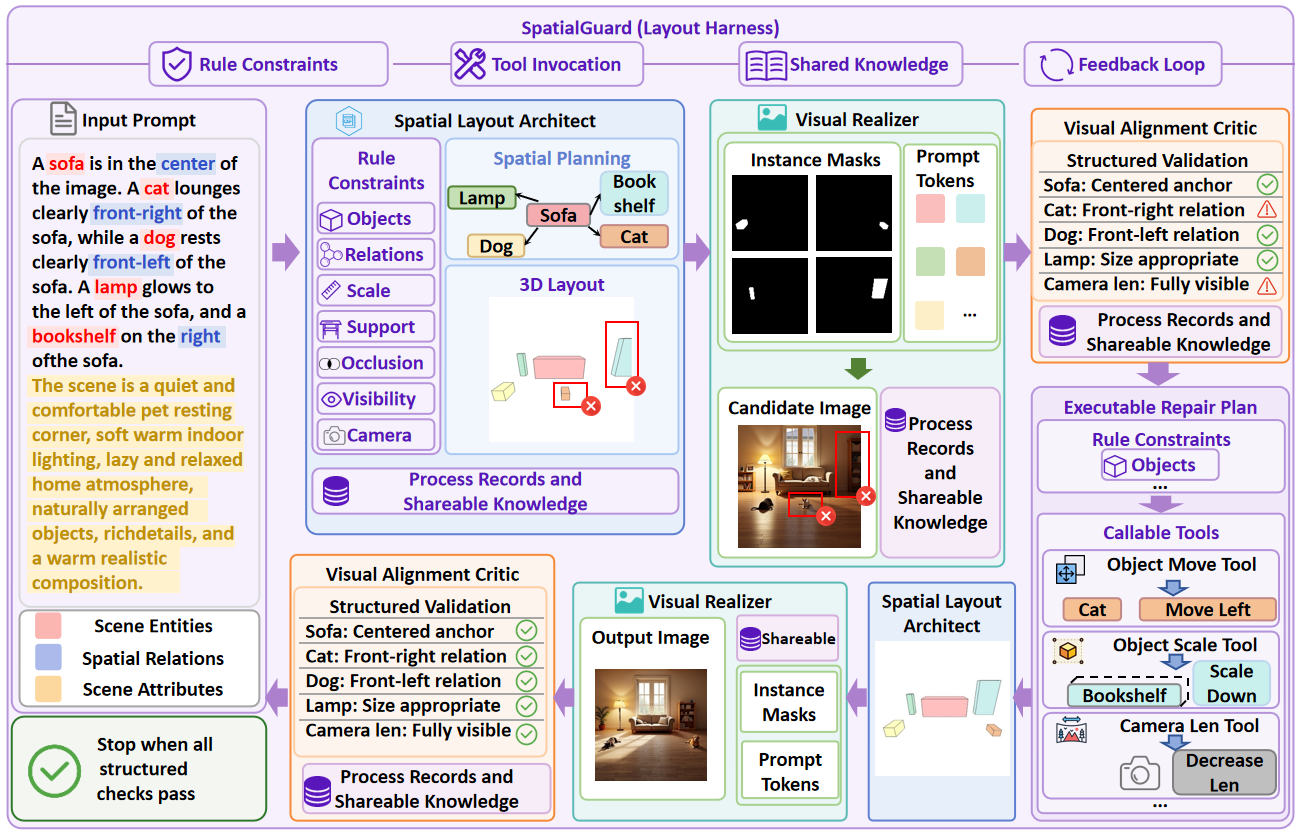
SpatialGuard由空间布局规划器、视觉生成器和视觉一致性评估器组成,形成“布局规划—图像生成—结果验证—问题修复”的闭环流程。与此同时,团队引入Layout Harness机制,通过规则约束、工具调用、共享知识和反馈闭环,持续维护多轮生成过程中的空间约束,提升图像对复杂空间语义的遵循能力。
实验结果表明,SpatialGuard能够更稳定地保留物体位置、方向、深度、尺度及可见性等空间关系,在复杂空间文生图任务中展现出优异性能。该研究为可控图像生成、虚拟场景构建、游戏资产设计、影视分镜制作及具身智能仿真等应用提供了新的技术路径。
论文第一作者为2022级直博生钱子赟,杨鼎康助理教授(A)和张立华教授为论文通讯作者。
原文链接:http://arxiv.org/abs/2609.01582
11、集群机器人系统实验室EMNLP 2026:面向多模态感知的自适应层次表示联盟框架
近日,集群机器人系统实验室(MAGIC Lab)在多模态感知领域取得最新研究成果,论文《Adaptive Hierarchical Representation Alliance for Multimodal Learning》被国际自然语言处理领域权威会议EMNLP 2026录用。论文第一作者为我院2023级博士生孟春雷,欧阳春青年副研究员和甘中学教授为共同作者。
在多模态人工智能系统中,语言、视觉、听觉等不同模态具有不同的信息结构和语义形成规律。现有方法通常将不同模态表示映射到单一潜在空间进行融合,隐含假设不同模态的有效信息处于相同语义深度。然而,语言往往依赖更深层的上下文抽象,而视觉和声学中的关键感知线索可能在浅层或中层表示中已经形成。这种语义粒度不匹配会导致传统融合方式削弱模态特有信息,并降低模型在噪声、模态缺失等复杂条件下的可靠性。图1展示了不同模态语义信息形成过程中的层级差异。我们研究发现,语言、视觉和声学模态与任务目标相关的信息往往出现在不同语义深度:文本模态通常在更深层表示中包含更加丰富的语义信息,而视觉和声学模态中的感知线索可能在浅层或中层已经具有较强判别能力。这表明传统单层融合方式难以充分利用不同模态的层级特征,是导致多模态表示不足的重要原因。
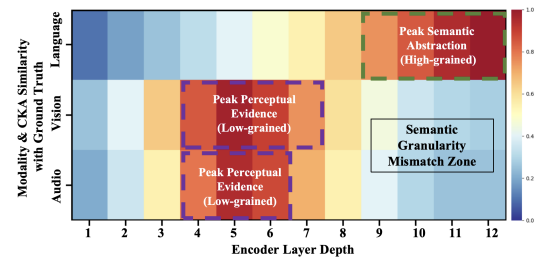
图1. Layer-wise CKA similarity with labels,展示 text / vision / audio 在不同层级与标签相关性的变化。
针对上述问题,研究团队提出自适应层次表示联盟框架(Adaptive Hierarchical Representation Alliance, AHRA),从单一潜在空间融合转向多层级语义协同建模。AHRA首先对不同模态进行层次化表示学习,在多个语义层级中分别构建共享表示与私有表示:共享分支用于捕获跨模态一致性信息,私有分支用于保留不同模态独有的判别线索,从而避免细粒度模态信息在融合过程中被稀释。在表示建模基础上,AHRA进一步设计自适应专家联盟模块(Adaptive Expert Alliance, AEA)。该模块利用跨模态专家处理共享语义交互,同时通过模态特定专家增强私有信息,并引入前景筛选机制(foreground exam)选择更具任务价值的私有token,减少冗余和噪声信息干扰。此外,层次化多专家协同融合模块(Hierarchical Multi-Expert Co-Fusion, HMEC)进一步实现不同专家以及不同语义层级之间的动态协同,提升多模态融合的灵活性和可靠性。
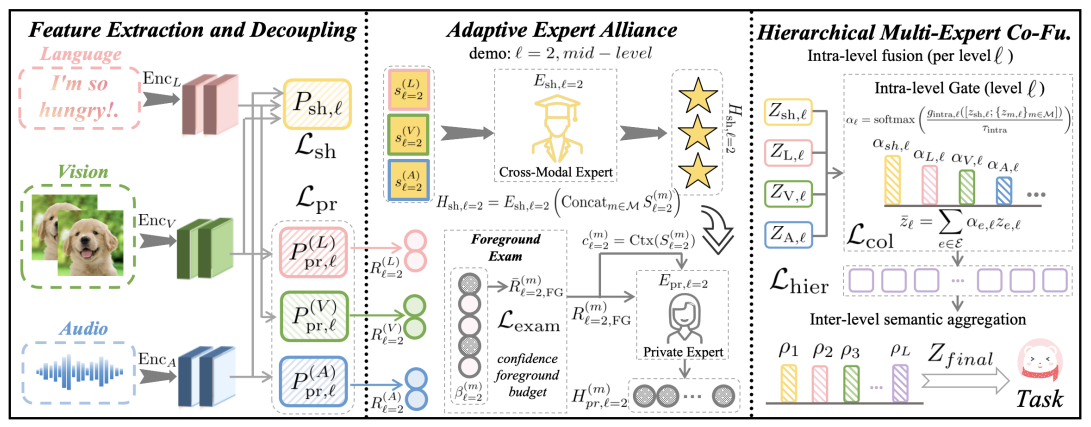
图2. Overview of AHRA framework
论文在多个基准数据集上进行了系统验证。实验结果表明,AHRA能够有效提升多模态表示质量,并在噪声干扰和模态缺失条件下保持稳定性能,验证了层次化语义建模和专家协同机制在构建可靠多模态智能系统中的有效性。
该研究为复杂场景下多模态感知与理解提供了新的表示学习范式,并为未来机器人感知、具身智能以及通用世界模型中的可靠多模态推理提供了重要探索。
论文题目:Adaptive Hierarchical Representation Alliance for Multimodal Learning
论文链接:https://arxiv.org/abs/2608.22863
12、可信具身智能研究院EMNLP 2026:CoDiQ:面向可控难度问题生成的测试时扩展框架
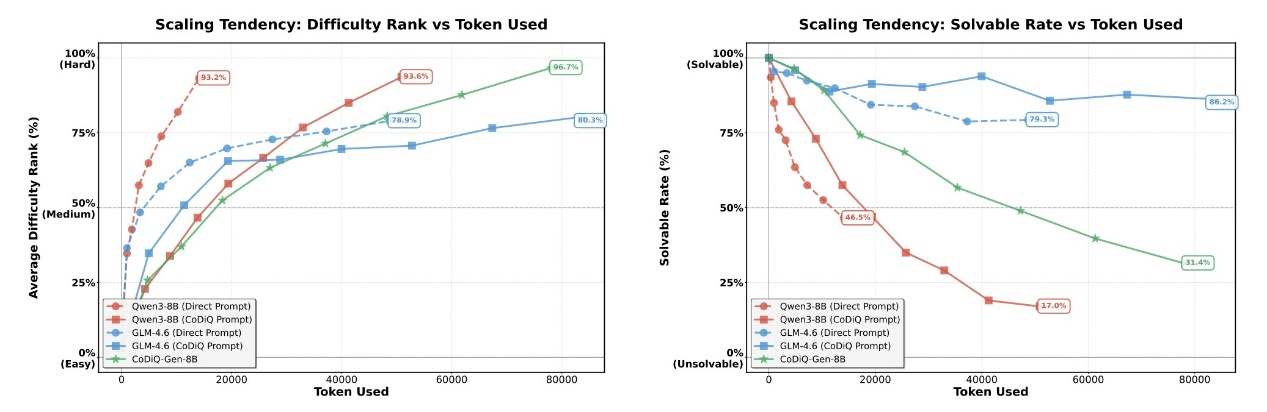
近日,我院可信具身智能研究院在大模型推理数据合成领域取得新进展,相关成果以"CoDiQ: Test-Time Scaling for Controllable Difficult Question Generation"为题被自然语言处理领域权威会议EMNLP 2026录用。大型推理模型(LRM)的能力提升高度依赖于高难度、竞赛级问题的训练数据,然而现有自动化问题合成方法普遍存在难度控制精度不足、计算开销高、难以规模化生成竞赛级问题等瓶颈。针对这些问题,本研究提出CoDiQ(可控难度问题生成)框架,通过测试时扩展实现细粒度的难度控制,同时保证生成问题的可解性。研究团队首先揭示了一种"测试时扩展倾向"现象:扩大推理过程的token预算能够提升问题难度,但同时会降低问题的可解性;在此基础上,团队进一步刻画了决定模型生成高难度且有效问题能力上限的内在属性。基于这些发现,团队基于Qwen3-8B训练得到CoDiQ-Generator,有效提升了模型生成高难度问题的能力上限,使其更适合构造具有挑战性的问题。依托CoDiQ框架,团队构建了包含4.4万条竞赛级问题序列的CoDiQ-Corpus数据集。人工评估结果表明,该数据集中的问题难度显著超过LiveCodeBench和AIME等主流基准,且可解率超过82%。实验证明,使用CoDiQ-Corpus训练大型推理模型能够显著提升其推理性能,验证了规模化生成难度可控的训练问题对增强模型推理能力的有效性。团队已开源CoDiQ-Corpus、CoDiQ-Generator及相关实现代码,以支持后续相关研究。
第一作者为博士生彭中园,通讯作者为我院曹艺馨教授和字节的张舸研究员。
论文链接:https://ieeexplore.ieee.org/document/11606480/
13、可信具身智能研究院ECCV 2026:NVM:基于噪声方差匹配的高精度少步扩散反演方法
近日,我院可信具身智能研究院在扩散模型反演与图像编辑领域取得新进展,相关成果以“Jumping the Landing Phase: Noise Variance Matching Enables Accurate Few-Step Inversion”为题被计算机视觉领域权威会议ECCV 2026录用。 扩散模型反演旨在将真实图像映射回扩散噪声空间,是实现高保真图像重建与编辑的重要基础。然而,经典DDIM反演在少步设置下容易产生明显的重建误差。本研究发现,其根本原因在于反演过程中模型需要利用较低噪声水平的潜变量预测较高噪声水平的噪声,导致噪声幅度被系统性低估,从而产生“部分去噪”现象。进一步分析表明,迭代反演方法ReNoise的大部分性能提升实际发生在早期的“着陆阶段(landing phase)”,此时预测噪声的方差快速调整至合理尺度,而后续迭代收益有限。基于这一发现,研究提出噪声方差匹配方法NVM,通过参考前向加噪样本直接校准预测噪声方差,使反演过程能够跳过计算开销较大的着陆阶段,并结合注意力引导的空间掩码和少量迭代细化进一步提升重建质量。 实验表明,NVM在HPDv2和MS-COCO等数据集上的少步图像重建中显著优于多种现有反演方法,同时在PIE图像编辑基准上兼顾背景保持能力与编辑可控性;相比ReNoise,NVM使用显著更少的UNet调用,并实现约3倍的加速。
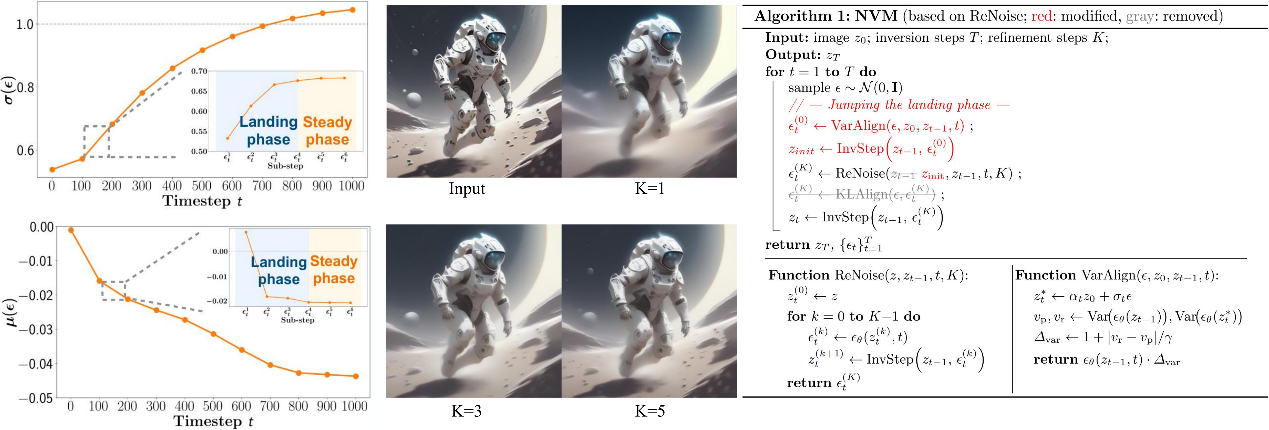
第一作者为2023级博士生罗扬,通讯作者为我院陈智能教授。研究得到国家自然科学基金项目资助。
论文链接:https://eccv.ecva.net/virtual/2026/poster/4842
14、可信具身智能研究院ECCV 2026:UniRec-0.1B:仅用0.1B参数实现文本与公式的统一识别
近日,我院可信具身智能研究院在文档智能解析领域取得重要进展,相关成果以 "UniRec-0.1B: Unified Text and Formula Recognition with 0.1B Parameters" 为题被计算机视觉领域权威国际会议 ECCV 2026(European Conference on Computer Vision)录用。文本与公式是文档的核心信息载体,对二者的准确高效识别是构建鲁棒、可泛化文档解析系统的关键前置环节,也是检索增强生成、科技文献理解及多模态智能体交互等应用的基础感知入口。但现有视觉语言模型虽已实现文本与公式统一识别,却普遍存在参数体量庞大、计算开销高昂的问题,严重制约其在大规模文档处理场景中的实际落地。针对该挑战,从"模态解耦与分而治之"的视角出发,探索出以极小模型实现高精度的新路径。定量揭示文本与公式区域占据文档页面区域数量的97.43%、消耗主流解析系统87.90%的推理时间瓶颈,并通过缩放律分析发现该类识别任务在约0.1B参数处即达到性能饱和。构建包含4000万样本、首个同时覆盖"文本+公式"两大模态、"字符—单词—行—段落—多段落"五个粒度层级及中英双语的大规模数据集UniRec40M;针对层级结构可变性与文本-公式语义纠缠两大核心难题,分别提出分层监督训练策略与语义解耦分词器,通过显式层级标记引导模型建立版面结构感知,并使同名符号在两种模态下获得独立语义嵌入,有效克服小模型上下文消歧能力不足的固有缺陷。实验结果表明,UniRec-0.1B在自建的UniRec-Bench及公开基准上全面超越通用视觉语言模型与主流文档解析专家模型:以仅相当于对比方法11%的参数量取得更优精度,公式识别精度较同类模型最高提升23.1%,推理速度实现2–9倍加速;将其嵌入现有解析框架后,在OmniDocBench整页解析任务上刷新SOTA性能。
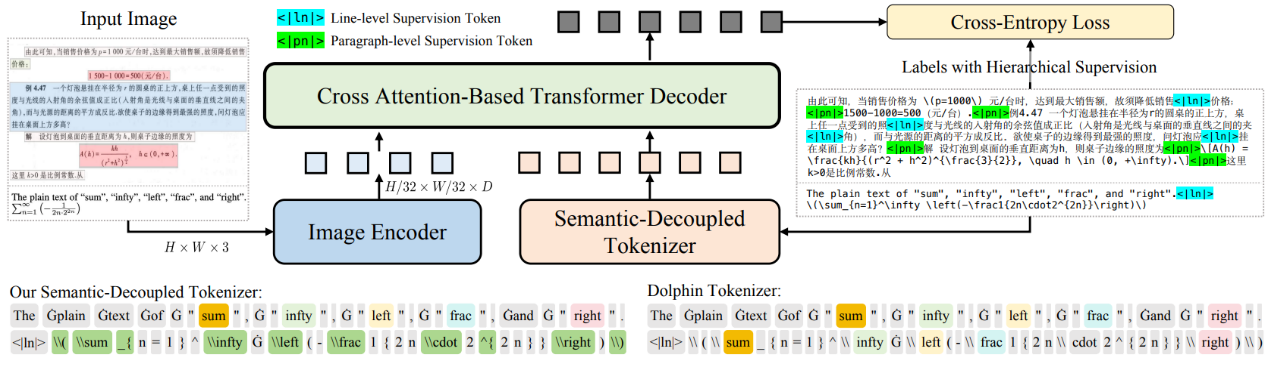
第一作者为2023级博士生杜永坤,通讯作者为陈智能教授、姜育刚教授。研究得到国家自然科学基金项目资助。
论文作者: 杜永坤,陈智能,谢雅真,白维康,冯浩,石威,苏宇辰,黄灿,姜育刚
论文链接:https://arxiv.org/abs/2512.21095